前言
最近只要打開 X (Twitter)、LinkedIn 或是逛逛技術社群,應該都會發現一個現象:AI 相關的新名詞多到讓人喘不過氣。昨天才搞懂什麼是 Prompt Engineering,今天又冒出 Context Engineering;才剛聽懂 Agent,馬上又有人在講 Squad、Fleet、Harness、Ralph Loop……每個詞聽起來都很潮,但仔細一問,好像也沒人能講得很清楚。
這篇文章的靈感主要來自 GitHub Blog 的一篇文章 《Decoding the new AI lingo: Loops, harnesses, squads, hill climbing… oh my!》,作者 Cassidy Williams 在 GitHub Podcast 上把這些近期竄紅的 AI 詞彙做了一次整理。我把裡面的重點名詞消化過後,用自己的話重新解釋,並額外補充幾個目前開發圈也很常聽到、但文章沒提到的詞(像是 Vibe Coding、MCP),一起彙整成這篇「AI 名詞小字典」。
這些名詞多半不是全新的技術,而是幫既有的做法重新包裝一個好記的稱呼。理解名詞背後代表的實際做法,比死記名詞本身重要得多。
名詞解釋
Loop Engineering(迴圈工程)
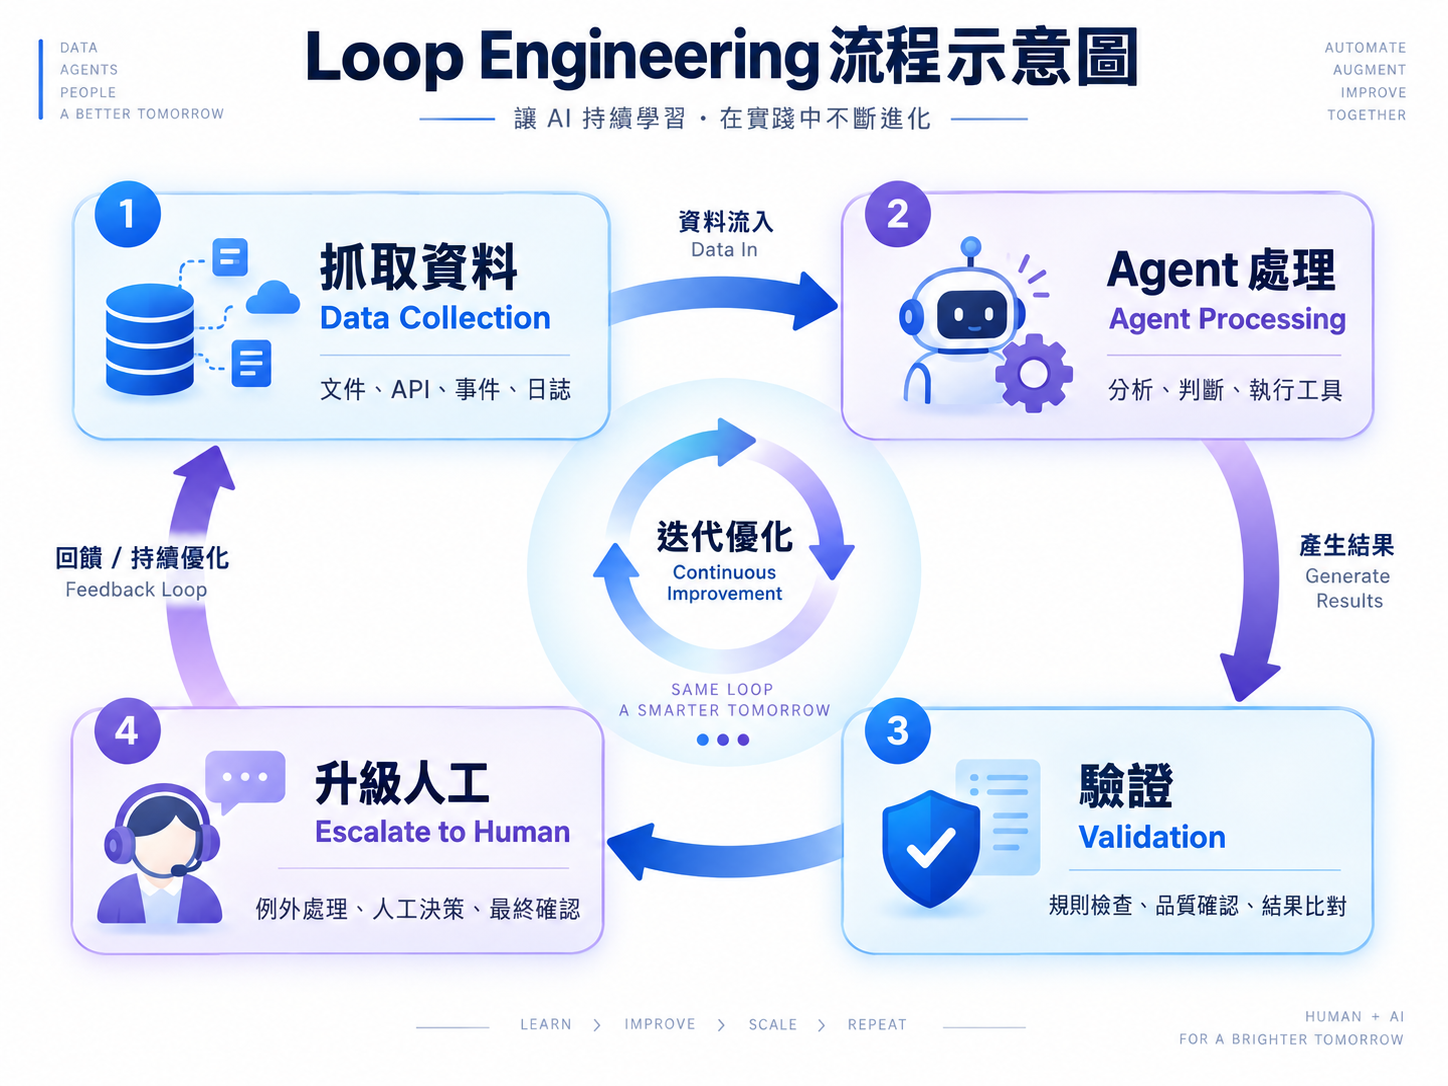
Loop Engineering 指的是:與其每次都手動下 Prompt 叫 AI Agent 做事,不如設計一套可以重複執行的系統,讓 Agent 自動照著固定流程運作。
舉例來說,與其每天早上手動叫 Agent「幫我看一下新的 Issue、整理摘要、提出修正建議」,不如做一個排程好的迴圈:定時抓取 Issue → 丟給 Agent 處理 → 驗證輸出結果 → 遇到卡關的案例才升級給人工處理。簡單來說,就是幫 AI 打造一個「AI 原生版的 cron job」。
一個設計良好的 Loop,通常會包含幾個關鍵元素:
- Skills:可重複使用的技能/知識模組
- Observability:可觀察、可追蹤每一次執行的狀況
- Validation:自動驗證輸出是否符合預期
- Routing:依情境將任務導向不同的處理路徑
- Checkpoints:關鍵節點留存狀態,方便中斷與恢復
Ralph Loop(暴力流迴圈)
Ralph Loop 是 Loop Engineering 概念下比較「暴力」的一種實作方式:給 Agent 一份詳細的任務說明(通常來自 PRD 或規格文件),然後讓它不斷重複執行,直到任務完成為止。
這種做法對於拆解大型任務、反覆進行「規劃 → 執行 → 檢查」的循環很有幫助,但缺點也很明顯——每多跑一輪就多燒一次 Token、多耗一些運算資源,效率不一定划算。
Loop Engineering 想解決的,正是讓這種「一直叫 Agent 再試一次」的暴力循環,變得更有結構、更可控。
Squad 與 Fleet(多 Agent 協作)
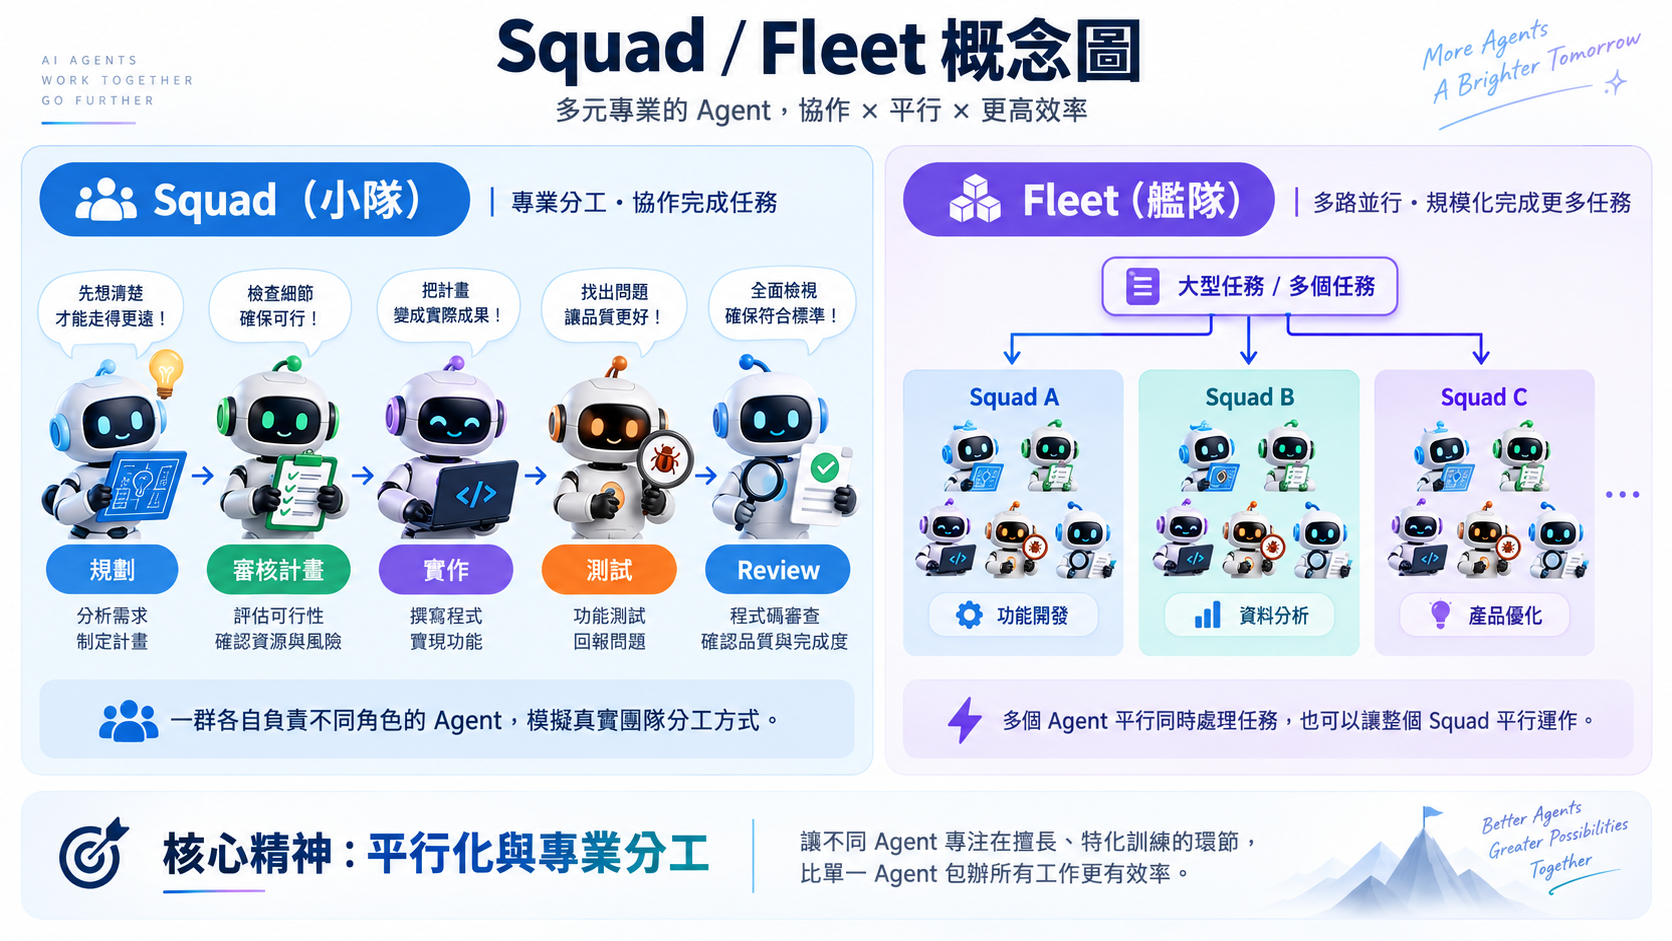
如果說 Loop 定義的是「工作流程長什麼樣子」,那 Squad(小隊) 和 Fleet(艦隊) 描述的就是「多個 Agent 要怎麼一起參與這個流程」。
- Squad:一群各自負責不同角色的 Agent,通常會模擬真實團隊的分工方式——一個負責規劃、一個負責審核計畫、一個負責實作、一個負責測試、一個負責 Review。
- Fleet:多個 Agent 平行同時處理任務。你可以讓一整個 Squad 以 Fleet 的方式平行運作,也可以讓他們照順序接力執行。
這種做法的核心精神是平行化與專業分工:與其讓單一 Agent 什麼都做,不如讓不同 Agent 專注在自己擅長、經過特化訓練的環節,效率自然更高。
Harness(載具/框架)
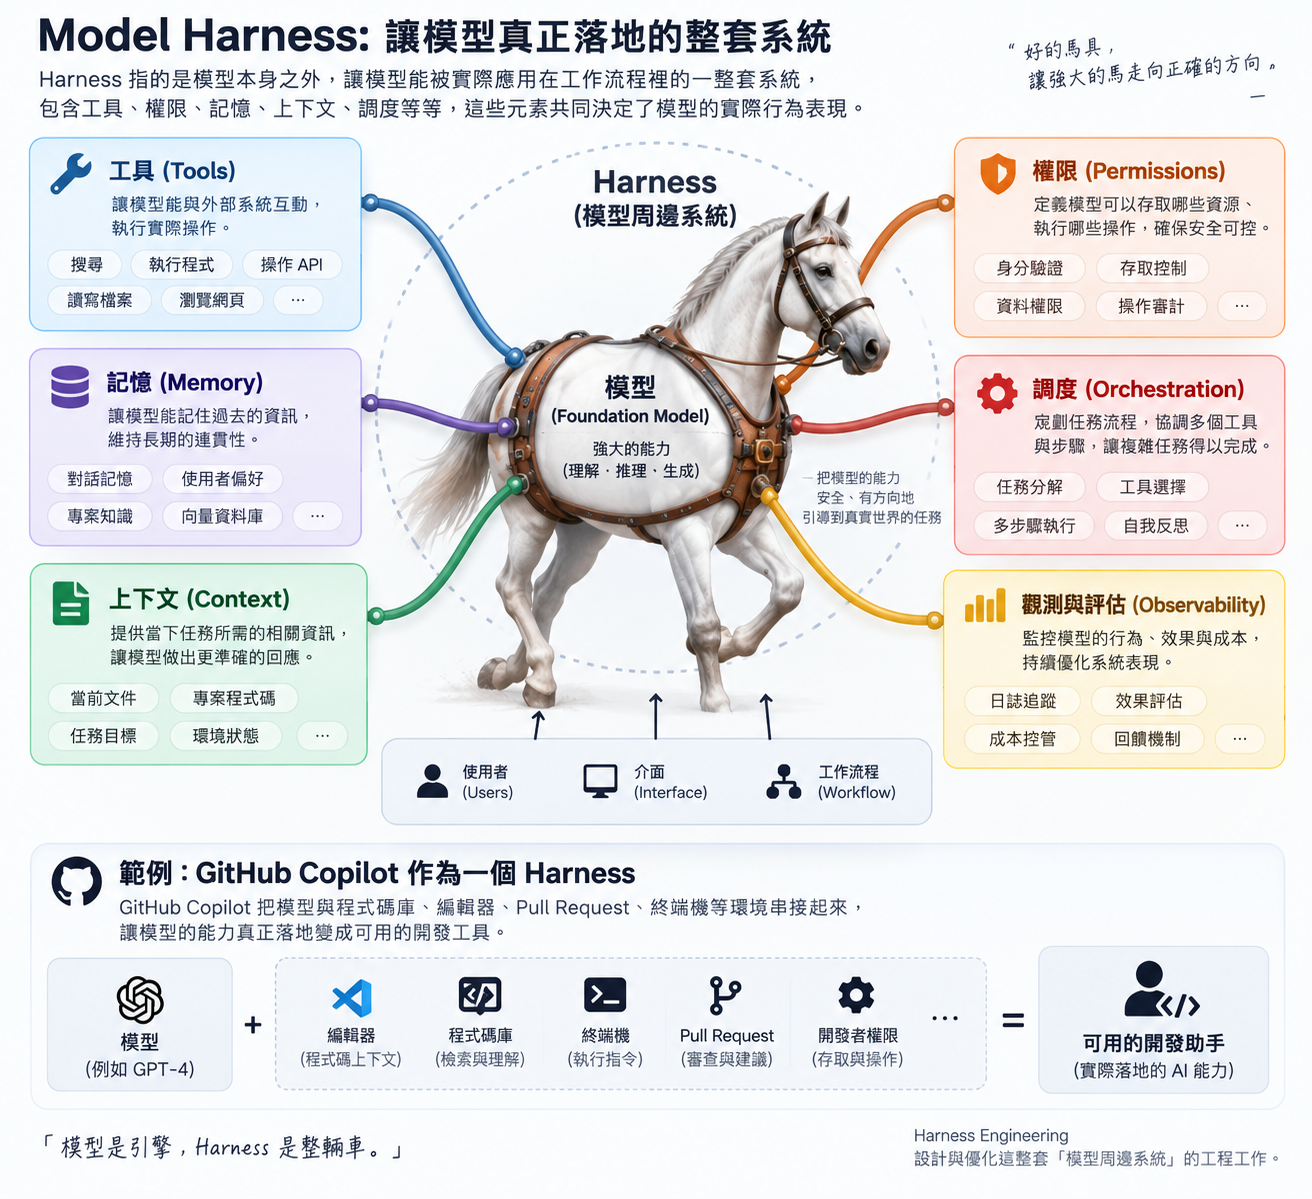
Harness 指的是模型本身之外,讓模型能被實際應用在工作流程裡的一整套系統——包含工具(Tools)、權限(Permissions)、記憶(Memory)、上下文(Context)、調度(Orchestration)等等,這些東西共同決定了模型的實際行為表現。
這個詞取自「馬具」的意象:模型就像一匹狂野奔跑的馬,而 Harness 就是那副馬具,能安全地引導這股力量去完成任務,而不是讓馬亂跑。
GitHub Copilot 本身就是一個很好的 Harness 範例——它把模型與程式碼庫、編輯器、Pull Request、終端機等環境串接起來,讓模型的能力真正落地變成可用的開發工具。當你聽到「Harness Engineering」,指的就是設計與優化這整套「模型周邊系統」的工程工作。
Hill Climbing(爬山優化)
Hill Climbing 用來形容持續透過回饋來改善 Agent 與 Harness 的過程。
具體做法可能是:用 Evals(評估工具)衡量 Agent 的輸出是否符合預期,然後不斷調整 Harness 直到結果變好。舉例來說,如果你的 Agent 負責 Review Pull Request,Hill Climbing 就是持續檢查它是否真的抓得到有意義的 Bug、給出有用的建議,然後根據結果調整工具鏈,讓表現一次比一次更好。
簡單來說,這是一個「觀察 → 評估 → 調整 → 再觀察」不斷疊代優化的過程,跟機器學習裡「爬山演算法」逐步逼近最佳解的概念很類似。
Forward Deployed Engineer(前線部署工程師)
這個職稱其實不是什麼新東西,只是套上了 AI 的外皮讓它聽起來比較潮而已。本質上,Forward Deployed Engineer 就是一種面對客戶的工程師——可能是 Sales Engineer 或 Solutions Engineer,只是現在多半聚焦在 AI 相關的技術上。
如果你沒聽過這個職位,可以想像成:這個人會直接與客戶密切合作,協助把技術方案導入、客製化到客戶自己的環境裡。放到 AI 的脈絡下,就是協助企業把 AI 工具、工作流程、Agent 整合進他們既有的系統當中。
封閉模型、開放權重與開源模型
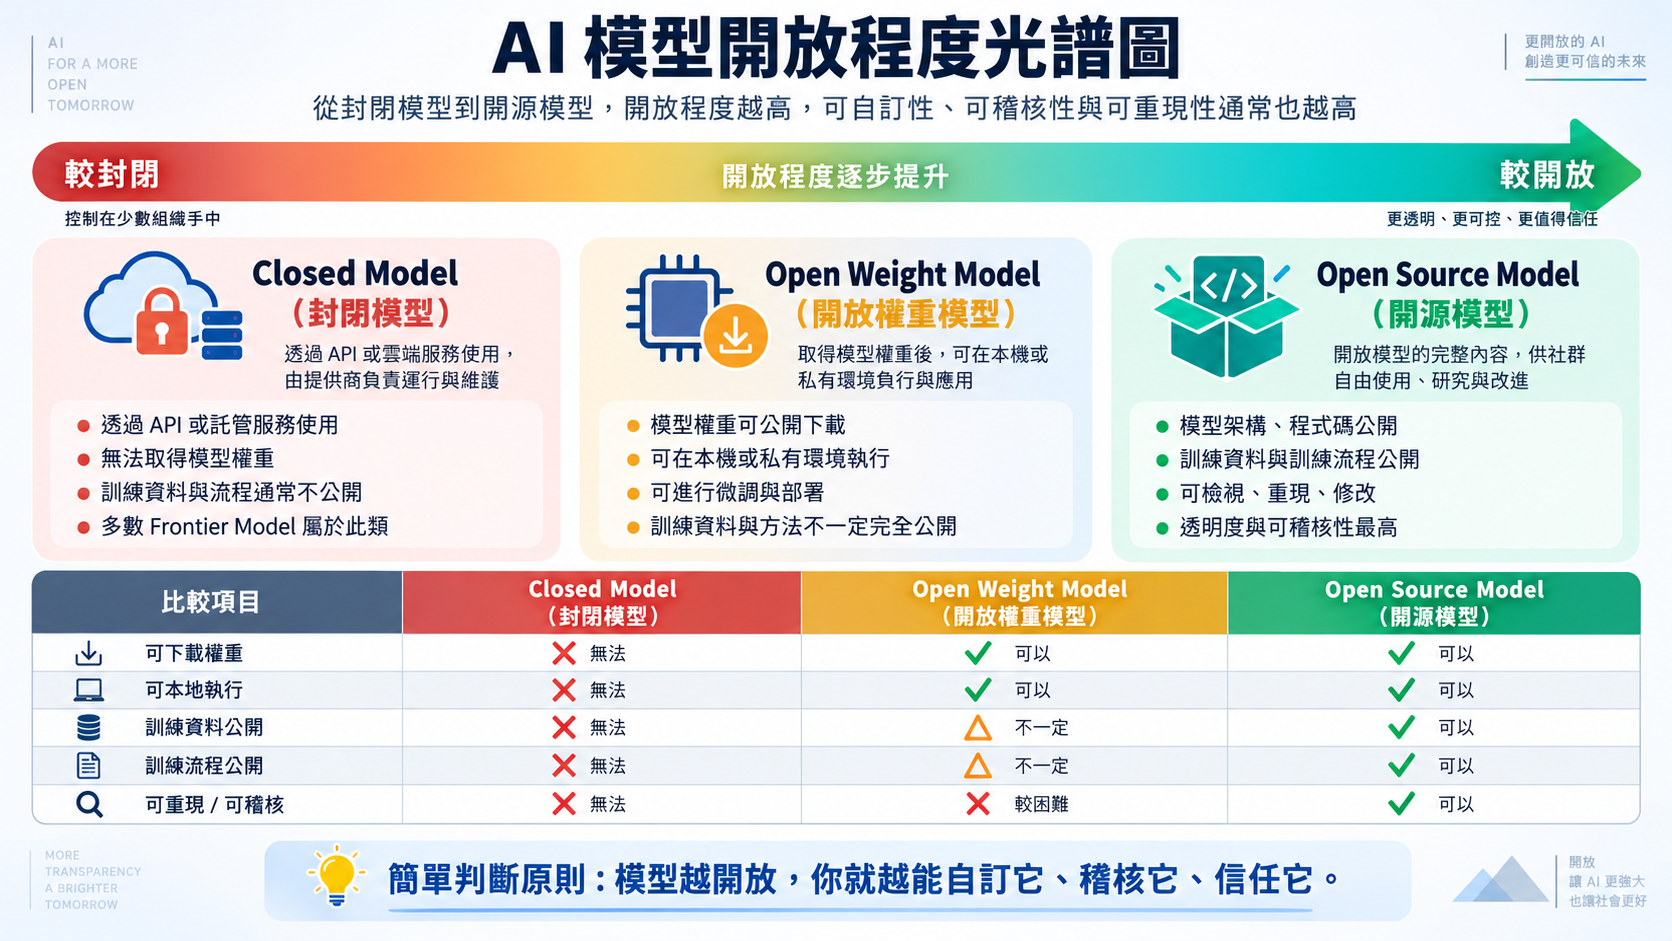
AI 模型的「開放程度」其實有好幾種層級,常常被搞混:
- Closed Model(封閉模型):只能透過 API 或託管服務使用,開發者拿不到底層權重、訓練資料或訓練流程。市面上最知名的前沿大模型(Frontier Model)多半屬於這一類。
- Open Weight Model(開放權重模型):模型權重(可以想像成決定「哪些輸入比較重要」的一堆參數旋鈕)是公開的,開發者可以下載回來,在自己的環境或本機執行。但訓練資料集與訓練方法不一定完全公開。
- Open Source Model(開源模型):更進一步,連模型架構、程式碼、訓練資料與訓練流程都完全公開,任何人都能檢視、重現、修改。
一個簡單的判斷原則:模型越開放,你就越能自訂它、稽核它、信任它。
Vibe Coding(氛圍寫碼)
除了 GitHub 那篇文章提到的詞彙外,這裡再補充幾個開發圈近期常聽到、但同樣容易讓人一頭霧水的名詞。
Vibe Coding 這個詞是由前 OpenAI/Tesla AI 負責人 Andrej Karpathy 在 2025 年提出的:開發者不再手動寫程式碼,而是用自然語言描述需求,完全交給 LLM 生成程式碼,甚至不太檢查、不太理解產生出來的程式碼細節,單純憑「感覺對不對」來持續給回饋、調整方向。
這種做法確實能大幅降低軟體開發的門檻,讓不會寫程式的人也能做出堪用的小工具;但也因為開發者往往看不懂自己「寫」出來的程式碼,在維護性、安全性上一直備受質疑——像是產生程式碼的安全漏洞比例偏高、技術債快速累積等問題,都是目前業界討論 Vibe Coding 時最常見的爭議點。
MCP(Model Context Protocol)
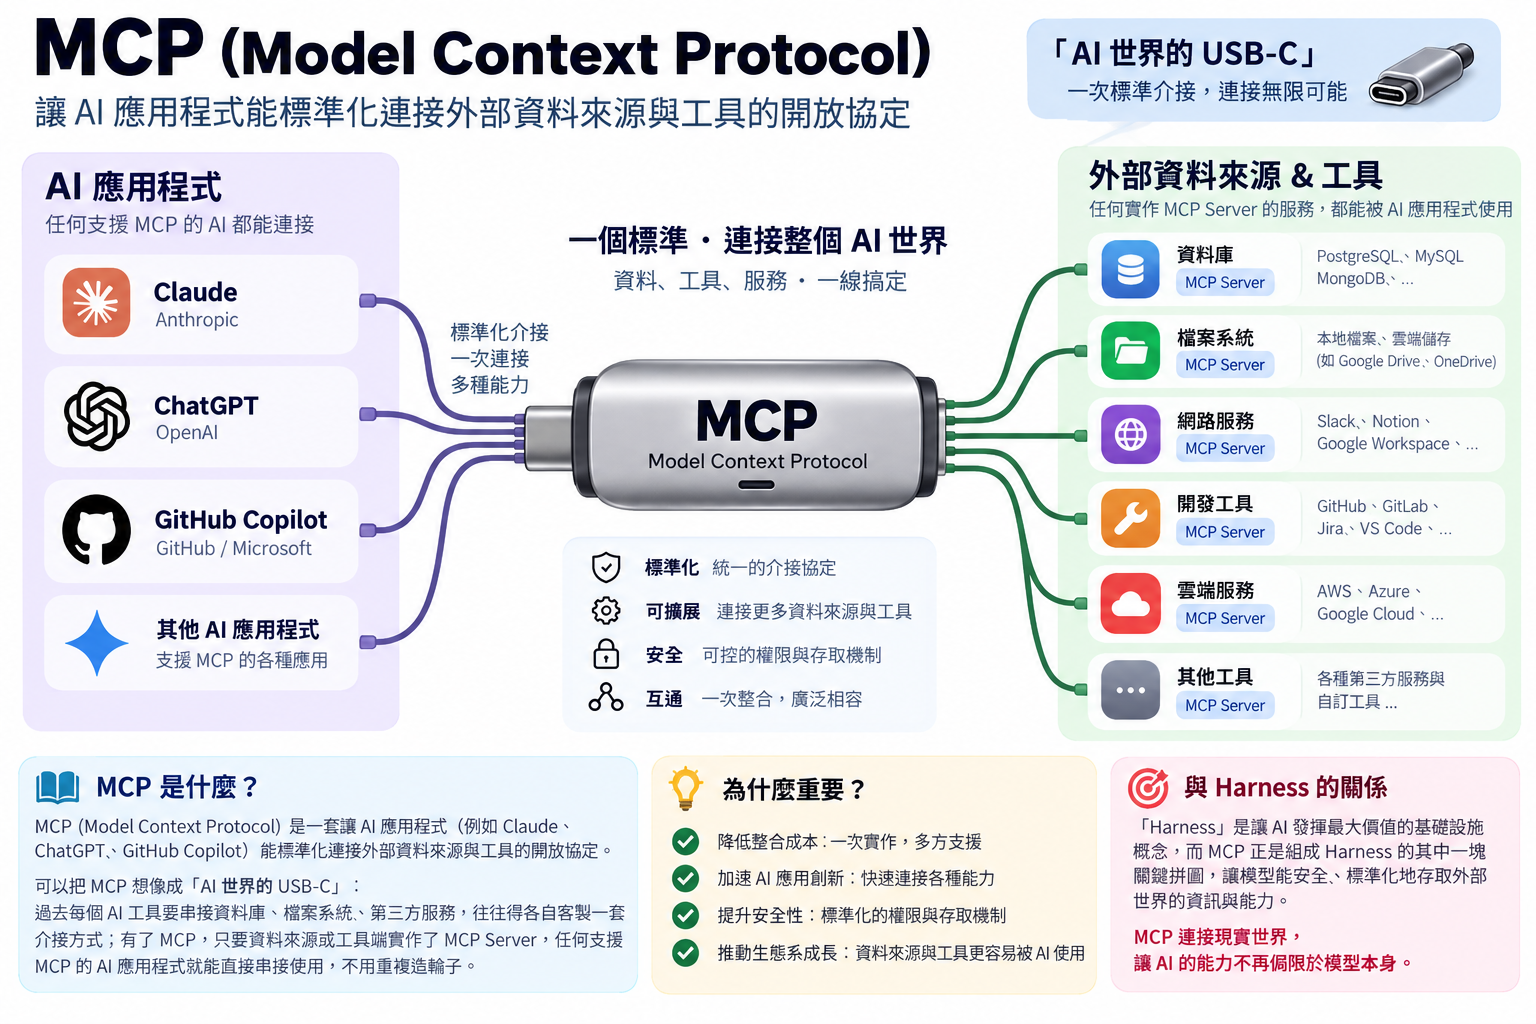
MCP 全名 Model Context Protocol,是一套讓 AI 應用程式(例如 Claude、ChatGPT、GitHub Copilot)能標準化連接外部資料來源與工具的開放協定。
可以把 MCP 想像成「AI 世界的 USB-C」:過去每個 AI 工具要串接資料庫、檔案系統、第三方服務,往往得各自客製一套介接方式;有了 MCP,只要資料來源或工具端實作了 MCP Server,任何支援 MCP 的 AI 應用程式就能直接串接使用,不用重複造輪子。
這也是為什麼「Harness」的概念會越來越重要——MCP 正是組成 Harness 的其中一塊關鍵拼圖,讓模型能安全、標準化地存取外部世界的資訊與能力。
結論
看完這些名詞,你可能會發現一件事:這些詞彙本身並不是什麼全新的黑科技,很多概念早就存在(排程任務、多角色分工、系統整合、模型授權方式……),只是套上了 AI 的外衣、換了個好記又好行銷的新名字。
正如原文作者提到的,這些術語會不斷演進——有些會留下來變成業界共通語言,有些則會隨著技術成熟被更好的說法取代。與其焦慮自己是不是又漏聽了什麼新名詞,不如把注意力放在名詞背後真正重要的問題上:
- 這個工作流程能不能穩定地重複執行?
- 要怎麼驗證每一次任務的產出是對的?
- 人類該在哪個環節介入、又該在哪個環節放手?
- 這個模型/系統的能力,我能信任到什麼程度?
- 這套系統要怎麼隨著時間持續變得更好?
搞懂這些底層問題,遠比記住一堆時髦名詞來得實用。畢竟名詞會過時,但這些工程上的核心課題,才是這波 AI 浪潮裡真正值得投入心力研究的地方。
如果想聽更完整的討論,也推薦直接收聽原文提到的 GitHub Podcast,裡面有更多關於這些名詞的討論細節。